

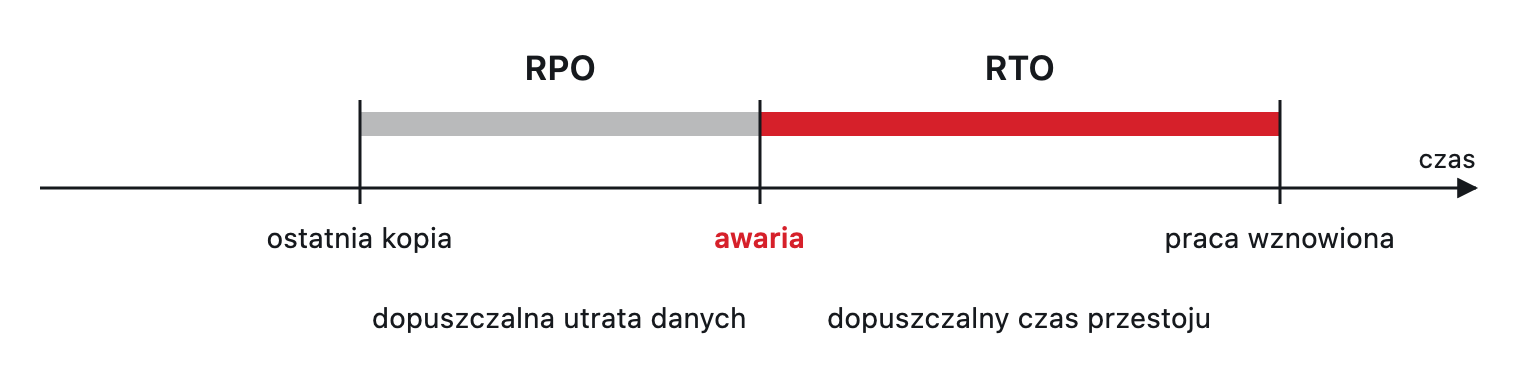
RTO i RPO to dwa parametry, które opisują, czego firma oczekuje po awarii. RTO (Recovery Time Objective) to maksymalny czas, po którym system ma znowu działać. RPO (Recovery Point Objective) to maksymalna ilość danych, liczona w czasie, którą firma może stracić — czyli jak stara może być ostatnia użyteczna kopia. Ustala się je osobno dla każdego systemu, zaczynając od pytania „ile kosztuje nas godzina bez tego programu”, a dopiero potem dobiera technikę: kopię poza siedzibą, replikację albo środowisko zapasowe.
RTO i RPO na jednym przykładzie
Przyjmijmy, że serwer z systemem sprzedażowym przestaje działać we wtorek o 14:00.
- Ostatnia kopia powstała o 2:00 w nocy. Dane wprowadzone między 2:00 a 14:00 przepadają. Faktyczna strata to 12 godzin pracy. Jeśli firma zakładała RPO równe 4 godziny, to cel nie został spełniony.
- System wraca do pracy w środę o 10:00. Przestój trwał 20 godzin. Jeśli zakładane RTO wynosiło 8 godzin, ten cel też nie został spełniony.
RPO patrzy wstecz od chwili awarii: ile pracy trzeba będzie wprowadzić ponownie. RTO patrzy w przód: jak długo ludzie nie mogą pracować. Jedno nie wynika z drugiego. Można mieć świeżą kopię i odtwarzać ją dwa dni. Można też podnieść system w kwadrans, ale ze stanem sprzed tygodnia.
Backup a Disaster Recovery
Te pojęcia często się myli, a odpowiadają na różne pytania.
| Backup | Disaster Recovery | |
|---|---|---|
| Na co odpowiada | Czy mam kopię danych? | Jak i gdzie uruchomię systemy po awarii? |
| Co obejmuje | Dane i ich wersje | Dane, serwery, sieć, dostęp użytkowników, kolejność działań |
| Typowe zastosowanie | Skasowany plik, uszkodzona baza, zaszyfrowane dane | Utrata serwera, serwerowni lub całej lokalizacji |
| Wynik | Plik, baza lub obraz dysku do odtworzenia | Działające środowisko, do którego logują się ludzie |
| Czego wymaga | Harmonogramu, retencji, testu odtworzenia | Planu, miejsca zapasowego, testu przełączenia |
Backup jest częścią Disaster Recovery, ale go nie zastępuje. Sama kopia nie mówi, na czym ją uruchomisz, skąd weźmiesz serwer, jak przekierujesz ruch i kto podejmie decyzję. Z kolei DR bez dobrej kopii nie chroni przed ransomware — replikacja wiernie powieli także zaszyfrowane dane. O samych kopiach piszemy osobno: kopia zapasowa odporna na ransomware.
Jak ustalić RTO i RPO dla każdego systemu
Nie zaczynaj od techniki. Zacznij od listy systemów i rozmowy z osobami, które z nich korzystają.
Krok 1. Spisz systemy
Wypisz wszystko, bez czego firma pracuje gorzej: system ERP lub księgowy, pocztę, pliki, stronę i sklep, telefonię, systemy produkcyjne, logowanie użytkowników. Przy każdym zapisz, gdzie fizycznie działa i kto za niego odpowiada.
Krok 2. Zapytaj o skutki przestoju
Dla każdego systemu odpowiedz na cztery pytania:
- Co przestaje działać w firmie, gdy ten system stoi godzinę? Dzień? Trzy dni?
- Czy pracę da się przez ten czas prowadzić inaczej (na papierze, telefonicznie)?
- Ile kosztuje ponowne wprowadzenie danych z ostatnich godzin i czy w ogóle jest możliwe?
- Czy są terminy zewnętrzne, których nie wolno przekroczyć (wysyłki, rozliczenia, zobowiązania wobec klientów)?
Krok 3. Zapisz zależności
System sprzedaży nie zadziała bez bazy danych, baza bez serwera, logowanie bez usługi katalogowej, a zdalny dostęp bez łącza i VPN. Elementy zależne od siebie uruchamia się kolejno, więc RTO całego procesu to co najmniej suma ich czasów, a nie czas najwolniejszego z nich. Kolejność uruchamiania powinna trafić do planu.
Krok 4. Nadaj wartości i klasy
Systemy zwykle układają się w trzy–cztery grupy. Poniżej przykładowy zapis.
| System | RTO | RPO | Uzasadnienie |
|---|---|---|---|
| ERP / sprzedaż | 4 godziny | 1 godzina | Bez systemu nie wystawiamy dokumentów i nie wydajemy towaru |
| Poczta | 8 godzin | 4 godziny | Kontakt z klientami; przez kilka godzin zastąpi ją telefon |
| Pliki firmowe | 24 godziny | 24 godziny | Większość bieżących dokumentów ludzie mają otwartych lokalnie |
| Strona internetowa | 48 godzin | 7 dni | Treść zmienia się rzadko, nie obsługuje sprzedaży |
To przykład, nie rekomendacja. Wartości są umowne i służą tylko pokazaniu formy. W firmie, która sprzedaje przez sklep internetowy, strona trafi na samą górę. W biurze projektowym najważniejsze będą pliki.
Krok 5. Sprawdź, ile to kosztuje
Im krótsze RTO i RPO, tym droższe rozwiązanie. Dlatego wartości ustala się dwa razy: najpierw „ile byśmy chcieli”, potem „na ile nas stać w porównaniu z kosztem przestoju”. Uczciwie zapisane RTO równe jeden dzień jest lepsze niż deklarowana godzina, której nikt nie sprawdził.
Warianty: od najtańszego do najszybszego
1. Kopia poza siedzibą
Dane trafiają regularnie do innej lokalizacji. Po awarii trzeba przygotować serwer lub maszyny wirtualne i odtworzyć na nich dane. RPO zależy od częstotliwości kopii, RTO od ilości danych i od tego, czy masz na czym je uruchomić. Najtańszy wariant, wystarczający dla systemów z dolnej części tabeli.
2. Replikacja
Zmiany z systemu produkcyjnego są na bieżąco lub w krótkich odstępach przesyłane do drugiej lokalizacji. Tam czeka aktualna kopia maszyn, gotowa do uruchomienia. RPO skraca się do minut lub pojedynczych godzin, RTO do czasu potrzebnego na start maszyn i przekierowanie użytkowników. Replikacja wymaga stabilnego połączenia między lokalizacjami.
3. Środowisko zapasowe
W drugiej lokalizacji stoi przygotowane środowisko: maszyny, sieć, adresacja, reguły dostępu, a czasem także działające równolegle usługi. Przełączenie jest szybkie i przećwiczone. To wariant dla systemów, których przestój od razu zatrzymuje firmę.
| Wariant | RPO | RTO | Koszt |
|---|---|---|---|
| Kopia poza siedzibą | Najdłuższe | Najdłuższe | Najniższy |
| Replikacja | Krótkie | Średnie | Średni |
| Środowisko zapasowe | Najkrótsze | Najkrótsze | Najwyższy |
Nie trzeba wybierać jednego wariantu dla całej firmy. Zwykle ERP dostaje replikację, a archiwum plików — kopię poza siedzibą.
Plan i jego test
Plan Disaster Recovery to dokument, który da się wykonać o trzeciej w nocy. Powinien zawierać:
- kto ogłasza awarię i kto decyduje o przełączeniu,
- kolejność uruchamiania systemów,
- jak użytkownicy dostaną się do środowiska zapasowego,
- gdzie są dane dostępowe (poza środowiskiem, które właśnie nie działa),
- numery kontaktowe do dostawców,
- jak wrócić do lokalizacji podstawowej po usunięciu awarii.
Plan bez testu jest hipotezą. Test przełączenia polega na faktycznym uruchomieniu systemów w lokalizacji zapasowej i sprawdzeniu, czy ludzie mogą w nich pracować. Mierzy się rzeczywisty czas i porównuje z założonym RTO, a stan danych — z RPO. Każdy test kończy się listą poprawek. Powtarza się go regularnie oraz po większych zmianach w środowisku.
Jak to wygląda w S-NET
Usługa Disaster Recovery
W ramach chmury S-NET dostępna jest usługa Disaster Recovery. Polega na replikacji systemów klienta do Data Center S-NET. RTO i RPO ustalamy z góry, przed uruchomieniem usługi, a scenariusze przełączenia regularnie testujemy. Po teście wiesz nie tylko, że kopia istnieje, ale też ile trwało uruchomienie z niej środowiska.
Gdzie leżą dane i kopie
Chmura S-NET działa w Data Center w Krakowie. Osobną usługą jest magazyn obiektowy S3 w Katowicach, z blokadą usuwania — mogą do niego trafiać kopie zapasowe. Dane pozostają w Polsce. Sama platforma chroni też przed usterką sprzętu: trzy kopie każdego dysku na trzech niezależnych serwerach i powrót maszyn do pracy na innym serwerze w ciągu kilku minut. To zabezpieczenie niezależne od planu DR; nie zastępuje ani kopii, ani replikacji.
Planowanie i wdrożenie
Jeśli nie masz jeszcze listy systemów ani ustalonych wartości, od tego zaczynamy. Wsparcie IT S-NET obejmuje planowanie i wdrażanie Disaster Recovery: ustalenie RTO i RPO, przygotowanie planu i jego testy. Punktem wyjścia jest audyt obecnego środowiska — użytkowników, serwerów, sieci, kopii i zabezpieczeń.
Sieć i sprzęt
Replikacja potrzebuje połączenia. Biuro lub serwerownię klienta można połączyć z chmurą S-NET dedykowaną transmisją, odseparowaną od internetu. Jeśli część systemów musi zostać na fizycznych serwerach, mogą one stanąć w kolokacji w Data Center S-NET i zostać połączone z chmurą oraz biurem prywatną siecią. O przenosinach sprzętu piszemy w tekście przeprowadzka serwerów do data center.
Jeden zespół
Awarie zgłasza się do Centrum Zarządzania Siecią (NOC), które pracuje 24/7. Jeśli łącze, chmurę i środowisko zapasowe masz w S-NET, zgłoszenie trafia w jedno miejsce i zwykle nie musisz ustalać, do którego dostawcy zadzwonić najpierw. Kto za co odpowiada, określa umowa.
Najczęstsze pytania (FAQ)
Czym różni się RTO od RPO?
RTO to czas, w którym system ma wrócić do pracy po awarii. RPO to maksymalny okres, z którego dane mogą zostać utracone, czyli wiek ostatniej użytecznej kopii.
Czy mała firma potrzebuje planu Disaster Recovery?
Potrzebuje przynajmniej jego prostej wersji: listy systemów, ustalonych RTO i RPO oraz sprawdzonego sposobu odtworzenia. Rozmiar planu zależy od tego, ile kosztuje przestój, a nie od liczby pracowników.
Czy backup wystarczy zamiast Disaster Recovery?
Backup odpowiada na pytanie, czy masz dane. Nie odpowiada, na czym i jak szybko uruchomisz systemy. Dla mniej ważnych systemów sama kopia poza siedzibą bywa wystarczająca, dla krytycznych zwykle nie.
Jak często testować plan Disaster Recovery?
W odstępach zapisanych w planie i po większych zmianach w środowisku. W usłudze Disaster Recovery S-NET scenariusze przełączenia są regularnie testowane.
Gdzie S-NET uruchamia środowisko zapasowe?
W Data Center S-NET. Systemy klienta są tam replikowane, a parametry RTO i RPO ustalane z góry.
Od czego zacząć
Spisz systemy i przy każdym zapisz dwie liczby: ile godzin możesz bez niego pracować i z ilu godzin dane możesz stracić. Z taką listą porozmawiaj z inżynierem S-NET — dobierzemy wariant do każdego systemu osobno.